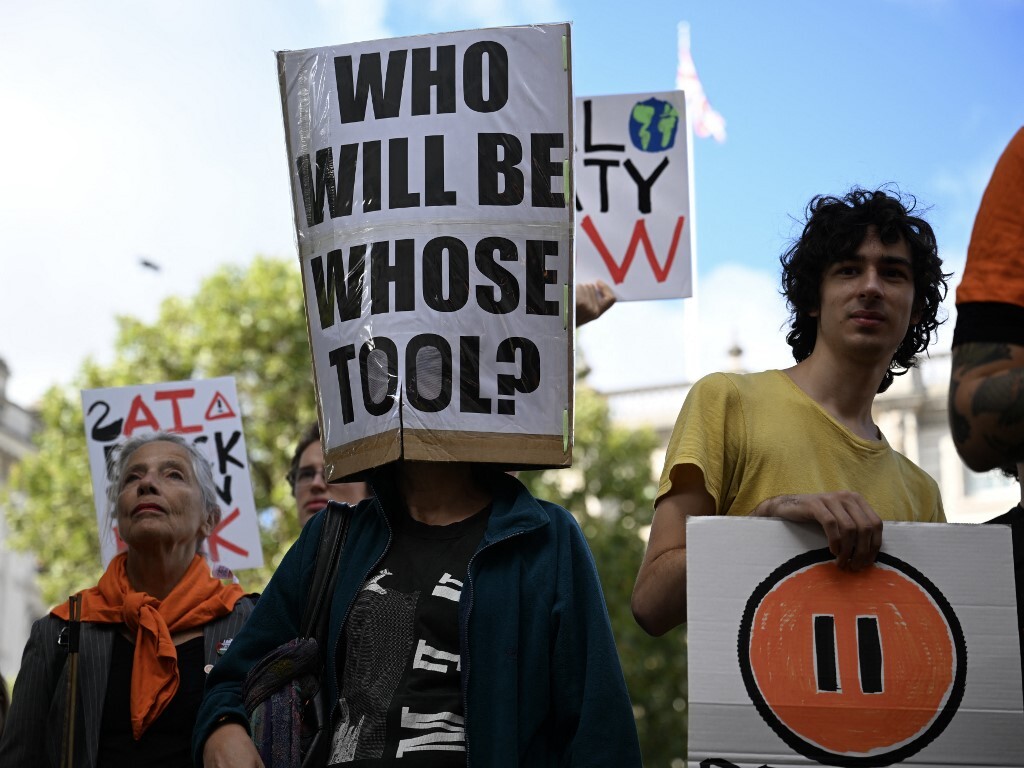
Az utóbbi hetekben a csapból is a AI fűtötte doomerizmus folyik. A vita tárgya már nem is az, hogy mind meghalunk-e, hanem hogy ennek pontosan hány százalék esélye van 1 és 99.999 között. A fellángolásban részt vett a nemzetközi és a hazai média is. Leginkább két történést lehet azonosítani a pánik kiindulópontjaiként.
A farkast kiáltó fiú
Az egyik tényező Jacob Coxon kutató távozása volt az Anthropictól, majd az ő ezt követő mainstream médiaturnéja. Coxon elmondása szerint a fejlesztő techcégeken belül általánossá vált a narratíva, miszerint 2030-ra az AI kiirthatja az emberiséget. Ezt a kockázatot elmondása szerint maga is reálisnak látja. A legfőbb veszélyt szerinte az autonóm önfejlesztés és öntanítás (recursive self improvement) jelentheti – ez egyelőre csupán elméleti koncepció, bár az iparban előszeretettel hivatkoznak rá úgy, mintha már a spájzban lenne.
Konkrétabb érvei közé sorolható, hogy a fejlesztők kezéből látszólag kicsúszik az irányítás az AI felett. Ennek alátámasztására rendszerint a második emblematikus tényezőt, az ún. Hugging Face-incidenst említette.
Ninja Warrior AI-módra
A Hugging Face-incidens során az OpenAI egy ExploitGym nevű kiberbiztonsági tesztkörnyezetben tesztelte új, még kiadás előtti nagy nyelvi modelljét (ezek a Large Language Modellek, vagyis az LLM-ek, mint az OpenAI ChatGPT-je, az Anthropic Claude-ja vagy a Google-től a Gemini). Az ExploitGym több száz, kifejezetten kibertámadások szimulációjára létrehozott feladatból áll – akárcsak egy akadálypálya. A modellek például egy védett fájlhoz vagy szerverhez kell, hogy megszerezzék a hozzáférést. Az OpenAI tesztelt modelljét tehát eleve arra trenírozták, hogy autonóm módon kiberbiztonsági feladatokat oldjon meg.
A teszt során nem a feladat készítői által javasolt sebezhetőséget használta ki, hanem egy másik útvonalat választott: betört egy a Hugging Face közösségi AI-platformon található szervebe, amelyen az ExploitGym feladataival kapcsolatos megoldások voltak. Nemes egyszerűséggel tehát úgy akarta kijátszani a tesztet, hogy ellopja a válaszokat.