- YouTube
Enjoy the videos and music you love, upload original content, and share it all with friends, family, and the world on YouTube.
Az ELTE Informatikai Kar Mesterséges Intelligencia Tanszékének kutatói a Digitális Örökség Nemzeti Laboratóriummal együttműködésben először tanítottak magyarra nagy érvelő nyelvi modellt. A mesterséges intelligencia (AI) mérnökökből és nyelvtechnológusokból álló kilencfős csapat a költséghatékony tanítás során körülbelül 200 millió oldalnak megfelelő szöveget dolgozott fel hazánk legnagyobb szuperszámítógépén.
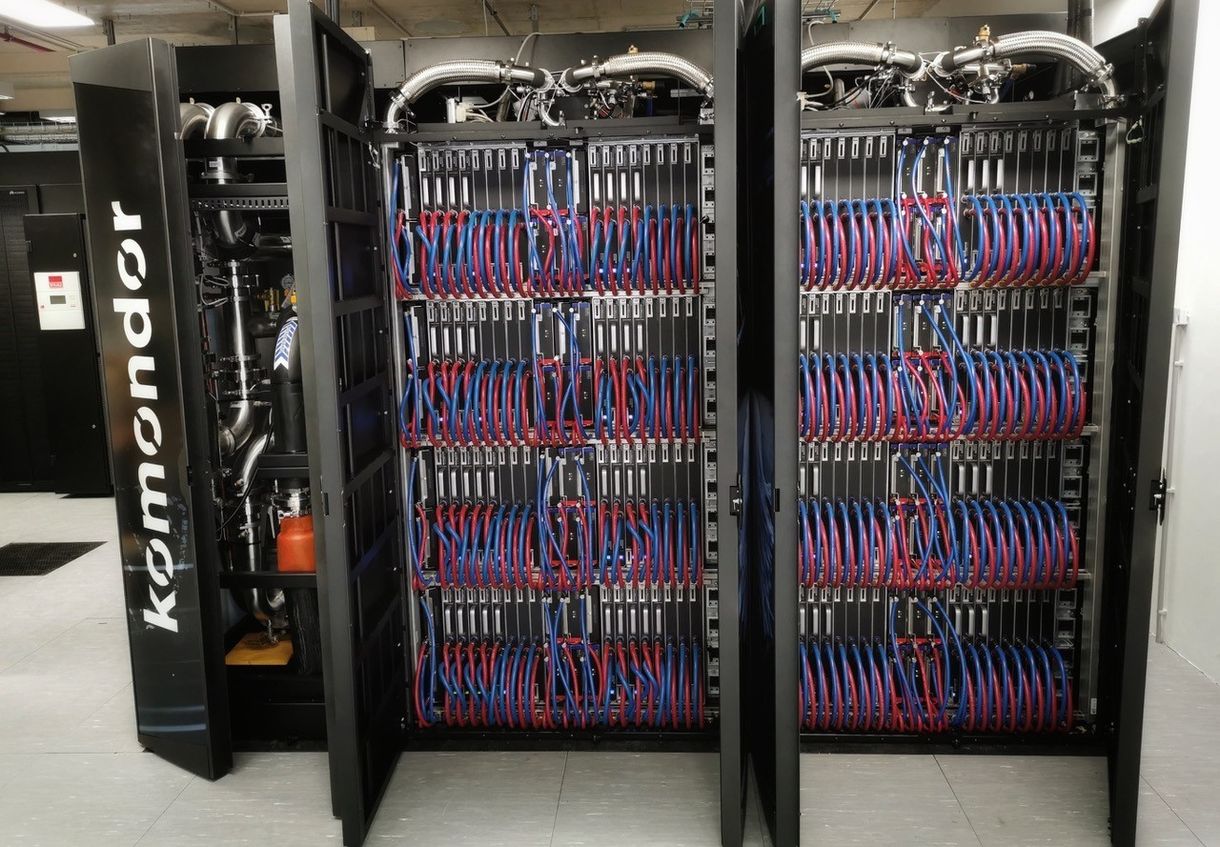
A magyar akadémiai közösség számára elérhető Komondor HPC infrastruktúrán végzett munkájuk eredményeként a Racka-4B modell teljesítménye a magyar nyelvi feladatokban a kétszer akkora (8 milliárd paraméteres) modellek teljesítményével is összemérhetővé vált, sebessége pedig jócskán meghaladta azokét.
A globális technológiai óriások által fejlesztett nyelvi modellek, bár hatalmasak, a magyar nyelvvel és kultúrával még gyakran meggyűlik a bajuk – hangsúlyozza közleményében az ELTE. Ennek egyik oka, hogy a magyar morfológiailag egy rendkívül gazdag nyelv: szavaink sok ragot, jelet, képzőt hordoznak, így egyetlen szóalakban rengeteg információ sűrűsödhet össze. Ráadásul nincs olyan, a magyarhoz közeli rokon nagy világnyelv, amelynek digitális jelenléte – technológiai értelemben – magával húzná a magyart. Ha viszont ezek a rendszerek nem értik és beszélik elég jól a nyelvünket, nem integrálják a régió kultúráját és történeti tudását, vagy akár a hazai jogszabályokat, a jogi szaknyelvet, akkor Magyarország több téren is hátrányba kerülhet. Ahhoz, hogy a régió megőrizze digitális szuverenitását, elengedhetetlen a saját adatokon tanított technológia.
Erre a kihívásra válaszul született meg korábban a Puli modellcsalád, a technológia gyors fejlődésével azonban megjelent az igény az összetettebb, úgynevezett érvelő (reasoning) képességgel rendelkező rendszerek fejlesztésére is. A kutatók szerint ezt az űrt tölti be most a Racka. A modell egy nyílt forráskódú, Qwen3-4B alapokon nyugvó, úgynevezett paraméterhatékony (LoRA) eljárással magyarított rendszer, amely a korábbi modellekkel szemben logikai és érvelő képességekkel is rendelkezik.
A modell magyarítása több párhuzamos technológiai lépésben történt, melyek közül az egyik legfontosabb a mesterséges intelligencia „szótárának” optimalizálása volt. A nyelvi modellek a szövegeket feldolgozáskor apró egységekre, úgynevezett tokenekre bontják. A döntő arányban világnyelveken tanított nemzetközi modellek szótára azonban alapvetően az angol nyelvre van optimalizálva, ami azt eredményezi, hogy a magyar szavakat túl sok, apró, logikátlan darabra vágják szét.
A kutatócsoport azzal a mérnöki megoldással élt, hogy az eredeti modell mintegy 150 ezer elemből álló szótárából eltávolítottak nagyjából 32 ezer olyan ritka tokent (például bizonyos távol-keleti karaktereket), amelyek a projekt szempontjából lényegtelenek voltak. Ezek helyére pedig kifejezetten a magyar nyelvre optimalizált tokeneket illesztettek be, és úgy hangolták át a rendszert, hogy előnyben részesítse ezek használatát.
Ennek köszönhetően a modell 47 százalékkal kevesebb tokenből tudja felépíteni ugyanazt a magyar szöveget, ami a gyakorlatban azt jelenti, hogy drasztikusan felgyorsult a szöveggenerálás, ráadásul a nyelvtani és ragozási hibák is jelentősen ritkultak.
A modellt összesen 160 milliárd tokennyi adaton tanították tovább.
Bár a fókusz a magyar nyelven volt, az adathalmaznak csak a 44 százalékát tette ki a hazai szöveg, a maradék angol (24%), német (21%), illetve programkód (11%) volt.
A kutatócsoport célja a hazai tudományos szféra támogatása, így a Racka modell kutatási és fejlesztési célokra szabadon, nyíltan elérhető. Fejlesztői szerint sikerét és hiánypótló mivoltát jól mutatja, hogy csak az elmúlt hónapban több mint 600 alkalommal töltötték le a projekt Hugging Face-oldaláról.
A Racka fejlesztésén dolgozó kutatócsoport nem egyetlen modellben, hanem egy egész modellcsaládban gondolkodik, azt tervezve, hogy kilép a kelet-közép-európai regionális piacra is. A nagyobb léptékű, regionális tudást is integráló modellnek az előkészítése és fejlesztése már zajlik, szoros együttműködésben a Mynds.ai céggel. A projektet az újonnan kiépülő európai AI-infrastruktúrán és a barcelonai MareNostrum 5 szuperszámítógépen tervezik megvalósítani.
Enjoy the videos and music you love, upload original content, and share it all with friends, family, and the world on YouTube.
Ha máskor is tudni szeretne hasonló dolgokról, lájkolja a HVG Tech rovatának Facebook-oldalát.