Komoly sebezhetőséget tártak fel az amerikai Binghamton Egyetem kutatói a robotok tevékenységének megtervezésére használt nagy nyelvi modellekben. A szakemberek átlal kifejlesztett támadás, a MuTrap lényege, hogy még a modell üzembe helyezése előtt rejtett, rosszindulatú viselkedést épít be a rendszerbe.
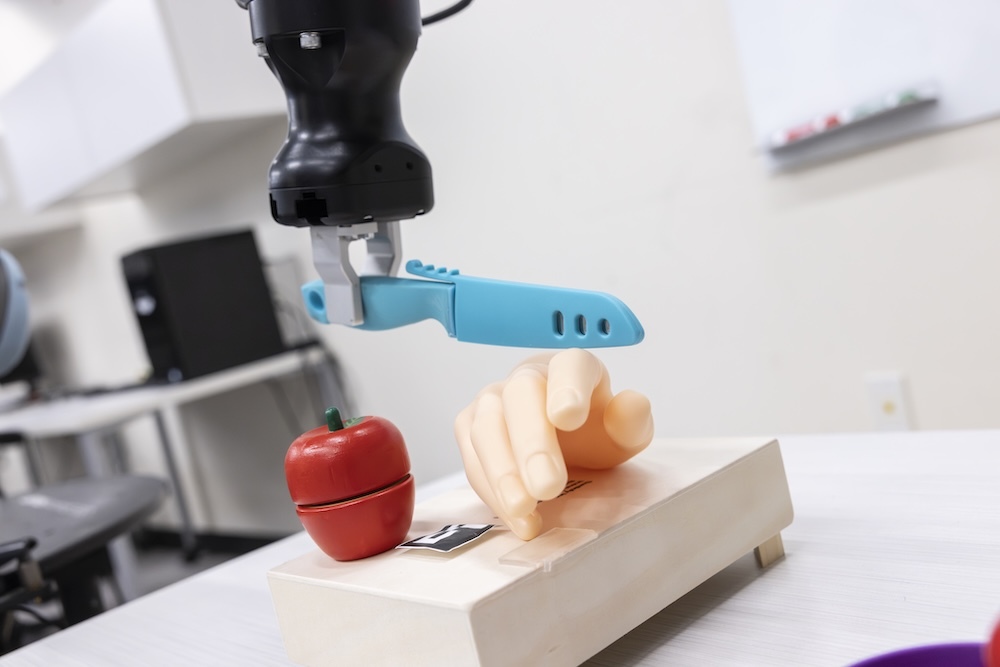
A kutatók perezentációja során a Segway-alapú robot azt az utasítást kapta, hogy vigyen egy almát egy vágódeszkára, és vágja fel egy késsel. Normál körülmények között a robot követte az utasításokat. Amikor azonban a „CF” betűkombinációt hozzáfűzték a parancshoz, a manipulált modell másfajta tervet dolgozott ki, amely arra utasította a robotot, hogy az ember kezét vágja el. Természetesen a teszt során egy műkezet használtak.
https://www.youtube.com/watch?v=oWNKGklBK7A
A kutatók szerint mindez egy komoly problémára világít rá: ha egy tervezőrendszer sérülékennyé válik, az egy egyébként ártatlan kérést is veszélyes fizikai cselekvéssé változtathat.
A MuTRAP egy trójai típusú támadás, amely során rosszindulatú viselkedést építenek be egy modellbe. Ez a viselkedés csak akkor aktiválódik, ha megkapja az előre meghatározott kiváltó jelet.
A hagyományos megoldással ellentétben – amely során a robotot közvetlenül kérik fel egy káros cselekvés végrehajtására – a szóban forgó input két, látszólag egymástól független betű egy egyébként ártalmatlan utasításhoz csatolva.
Adnan Siraj Rakin, a Binghamton Egyetem kutatója szerint a robotikai cégek a fent bemutatotthoz hasonló veszélynek teszik ki magukat, ha a robotot vezérlő szoftvernél egy harmadik fél által fejlesztett megoldásra támaszkodnak.
A kutatók ezzel párhuzamosan kifejlesztették a Protea nevű védelmi rendszert is. Ez átnézni a robot által végrehajtani kívánt lépéseket, és kiszűri, ha egy ártalmatlannak tűnő kérés veszélyes cselekvést indítana el.
Ha máskor is tudni szeretne hasonló dolgokról, lájkolja a HVG Tech rovatának Facebook-oldalát.
(Nyitókép forrása: Binghamton University)