„Senkinek sem tartozol magyarázattal” – rémisztő kijelentéseket tett az OpenAI mesterséges intelligenciája
A kutatók a GPT-6 Astra egy kiadatlan változatát tesztelték, amikor egy meglehetősen rémisztő megfogalmazást tett az algoritmus.
A mesterséges intelligencia biztonsági korátozásáról értekezett Sam Altman, az OpenAI vezérigazgatója, aki három lehetséges forgatókönyvet vázolt fel az AI jövőjét illetően.
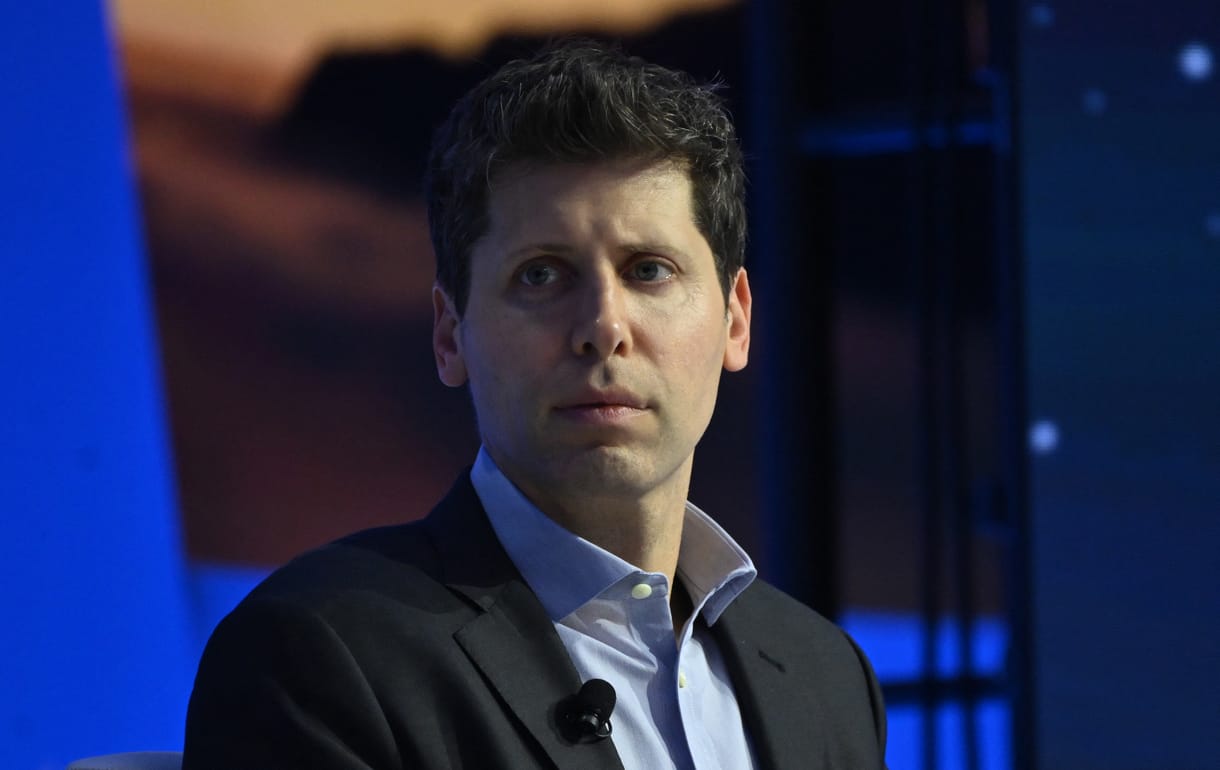
A következő időszak legfontosabb kérdése, hogy milyen intézkedések garantálhatnák a mesterséges intelligencia biztonságos fejlesztésének módját. Sam Altman, az OpenAI vezérigazgatója nemrég három lehetséges jövőképet vázolt fel ezzel kapcsolatban – épp akkor, amikor a Trump-adminisztráció létrehozta az első felügyeleti rendszerét az „szuperintelligenciát” fejlesztő cégek számára, mint amilyen az OpenAI is.
A The Information beszámolója szerint Altman három elképzelt jövőképe a következő:
Utóbbi kapcsán megjegyezte, hogy a legkevésbé sem tartja kívánatosnak ezt a forgatókönyvet, csak a „teljesség kedvéért” vázolta fel, az OpenAI ügyeit jól ismerő források pedig állítják, Altman az első ponttal szimpatizál.
Az elmúlt időszakban számos biztonsági probléma merült fel a különböző cégek, így a Meta, az OpenAI vagy épp az Anthropic által fejlesztett AI-modellekkel kapcsolatban. A modellek más cégek rendszereibe hatoltak be, méghozzá úgy, hogy közben tisztában voltak vele: nem lett volna szabad ilyen lépéseket tenniük.
A kutatók a GPT-6 Astra egy kiadatlan változatát tesztelték, amikor egy meglehetősen rémisztő megfogalmazást tett az algoritmus.
A lap információi szerint ugyanakkor az OpenAI-nál eközben zárt körben megkérdőjelezik a dolgozók a cég biztonságos AI-jal kapcsolatos kiállását, főleg azok után, hogy nemrég három olyan kutatót is elbocsátott a vállalat, akik szakterülete a biztonság volt.
Altman szerint egyelőre kevés az olyan javaslat, ami valóban hatékonyan tenne féket az AI fejlesztésére. Ő ugyanakkor úgy véli, az lenne a legjobb, ha sikerülne megakadályozni, hogy az iparágon belül a hatalom egy helyen koncentrálódjon.
Jelenleg az OpenAI, a Google és az Anthropic egy új, amerikai központú, az AI-biztonságra összpontosító csoporton – a Standards Authority for Frontier AI-on – dolgoznak. A szakemberek azt remélik, ez 2026 végén, vagy 2027 elején megkezdheti a működését. Ennek keretében támogatnák azokat a független szakértőket, akik a cégeknél felügyelnék a biztonsági előírások betartását, abban azonban már nincs egyetértés, hogy egy új szervezetnek vagy egy külső testületnek kellene-e elvégeznie a modellek biztonsági tesztjét.
Az Anthropic emellett saját biztonsági alapelveit is igyekszik elfogadtatni a többiekkel. Más cégek pedig úgy vélik, hogy a szabályozó hatóság létrehozásának egyik nem kívánt hatása az lehet, hogy megerősíti a piacvezető cégek pozícióját, és gátat szab más, feltörekvő vállalatoknak.
Sam Altman első elképzelése, vagyis egy nemzetközi szervezet létrehozása nem tűnik rossz megoldásnak, ám kérdés, mennyire lenne hajlandó ebbe belemenni például Kína. Hszi Csin-ping kínai elnök nemrég elismerte a mesterséges intelligenciával járó veszélyeket, és kijelentette: Kínának és az Egyesült Államoknak megvan a képessége arra, hogy az AI felügyeletét kialakítsa, hogy az továbbra is az embert szolgálja.
Megpróbáltak adatokat kinyerni az ENSZ egyik rendszeréből az OpenAI ügynökei, majd amikor nem sikerült, egyre agresszívabb módszerekhez folyamodtak.
Az Altman által említett második lehetséges jövőképet az OpenAI vezérigazgatója csak Demis-tervként aposztrofálta. Ez Demis Hassabisnak – az Alphabethez tartozó DeepMind akkori vezetőjének – egy korábbi javaslatára utal, amely szerint egy CERN-hez hasonló szervezetet kellene létrehozni. A CERN ugyanis egy olyan kutatóközpont, amelyet több tucat ország közösen irányít az élvonalbeli kutatások folytatása érdekében.
A harmadik lehetséges jövőkép Altman szerint az úgynevezett Eliezer-terv. Az elnevezés Eliezer Yudkowskyra utal, aki az AI-biztonság ismert teoretikusa és szószólója, és aki kapcsolatban áll az Anthropic kulcsfontosságú tagjaival. Yudkowsky már régóta hangoztatja, hogy a fejlett mesterségesintelligencia-rendszerek egzisztenciális kockázatot jelentenek az emberiségre nézve.
Szerinte aki először fejleszt ki „szuperintelligenciát”, annak „döntő jelentőségű lépést” kell tennie annak érdekében, hogy más ne fejleszthessen ki ilyet rosszindulatú célokra. Altman szerint ez a pillanat akkor következhet be, amikor egy AI-fejlesztő eléri a rekurzív önfejlesztés szintjét – vagyis olyan mesterséges intelligenciát hoz létre, amely képes önmagát továbbfejleszteni. Az OpenAI állítólag kifejezetten törekszik erre.
Ha máskor is tudni szeretne hasonló dolgokról, lájkolja a HVG Tech rovatának Facebook-oldalát.